


Ein Grundproblem bei der Auswahl besteht in dem Anspruch, viele Bedürfnisse zu verheiraten:
• Eine Grafikkarte soll über Kubernetes für (mehrere) ML-Tasks auswählbar sein (das schließt K3s basierend auf Alpine Linux mangels NVIDIA-Treiber aus). Der Host/ die VM benötigen dafür Hardware-Zugriff auf die Grafikkarte + Treiber.
• Einfache Reproduzierbarkeit und Upgradability von Kubernetes (Hier schließt sich für mich der manuelle Weg aus)
• Flexibilität zum Ad-hoc-Ausschalten von energiehungrigen Systemen
• Konfigurierbarkeit von Netzwerktopologie (das macht es schwierig mit einigen CNI‘s)
• Hardware-Support (Netzwerk-Virtualisierung, Grafikkarten-Virtualisierung)
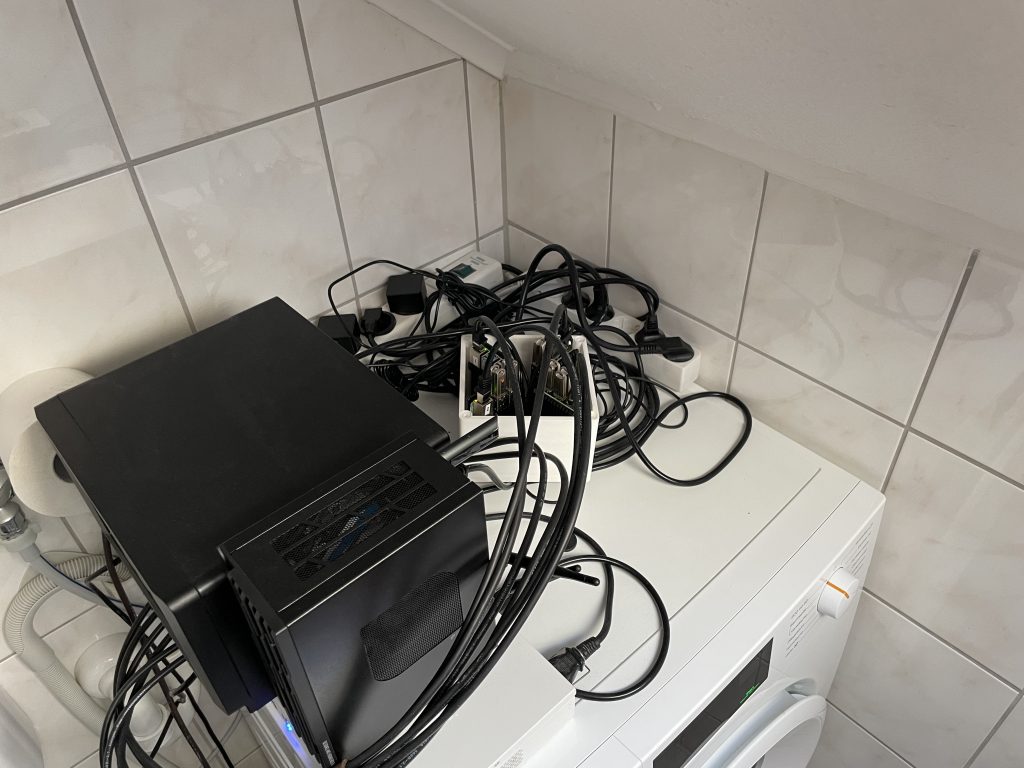
Wie oft gibt es in jedem der obigen Punkte mehrere Kandidaten, die ausscheiden. Letztlich habe ich mich für die DeepOps-Platform entschieden, da hier alle Konfigurationen direkt mit Nvidia-GPUs getestet werden und dennoch über Ansible und Kubespray genug Flexibilität zur weiteren Konfiguration geboten wird. Und Snaps (MicroK8s) haben mir eigentlich nie gefallen. Bei der gewünschten Hardwareausstattung fällt der gewonnene Rechner leider aus dem Rennen, da natürlich keine virtualisierbare PCI-GPU vorgesehen ist. Teile des Rechners werden für reguläre Workloads eingesetzt, für Dinge, die noch nicht für ARM Prozessorinstruktionen portiert/kompiliert wurden.
Das soll es ja bei Docker Images doch immer noch geben (war mir damals bei neo4j passiert, MySQL kann man zum Glück durch MariaDB substituieren). Als kleine Anekdote seien hier auch Entwicklungen von NVIDIA zu erwähnen, die dann zwar in Kubernetes laufen können, aber eben nur auf der x86 Plattform (z. B. der Gpu-Operator war bis vor Kurzem nur auf x86 lauffähig). Wer sich also ein Kubernetes bestehend aus Nvidia Jetson Nanos vorgestellt hatte, wurde erst mal enttäuscht.
Aber Kubernetes beizubringen, die gebotene Infrastruktur wiederum agnostisch zu nutzen, ist auch schwierig. Viele Plug-ins erfordern Konfigurationen, die Vendor-spezifisch sind. Ein Ingresscontroller freut sich nur allzu sehr, einen Application- oder Network-Loadbalancer aus dem Cluster heraus zu erstellen. Wenn wir hier den Zwischenschritt über den Openstack-Loadbalancer-Provider Octavia gehen, können wir hier auch Hardware-Appliances anbinden, und letztlich sogar aus Kubernetes heraus „beauftragen“.
Aber auch andere Dienste aus der Kubernetes-Welt wollen angebunden werden. Für einen Firmenauftritt müssen z. B. DNS-Einträge verwaltet werden. Wir wählen hier Openstack Designate als DNS-Server Provider, das eine API-Anbindung an Kubernetes Ingress-Controller über ein Plug-in bietet. Wenn man dann einen sogenannten Ingress für eine Website erstellt, wird ein neuer (oder bestehender) Loadbalancer provisioniert, der den einkommenden Traffic auf den Service verteilt. Dieser wiederum beliefert dann individuelle Pods, die anhand von Nutzung automatisch skalieren können. Dinge wie Wildcard-Zertifikate von Letsencrypt können dann ebenfalls über eine DNS01-Challenge akquiriert werden.
Wenn es um die Virtualisierung von Netzwerken und deren Anbindung geht, wird es schon schwieriger. Die zugrunde liegende Hardware und Kabel sollen geeignet abstrahiert werden.
Wenn es sich hier um „normalen“ Traffic handelt, kann dieser über Protokolle wie VXLAN bewerkstelligt werden. Dies ist auch die Standardlösung, die Openstack bereitstellt. Wenn es aber z. B. um latenzkritische Anwendungen geht, kann eine Hardware-basierte Lösung mit Software-Defined-Networking über OpenFlow sinnvoll sein.
Dann wird der Switch quasi über Openstack und letztlich Terraform programmiert. Hardware-nahe Implementierungen lassen sich auch aus Kubernetes heraus umsetzen (z. B. mit Multus CNI). Wirklich Sinn ergibt dies jedoch erst, wenn die tatsächliche Hardware (bei unserem PC leider Realtek) eine parallele Virtualisierung mit SR-IOV ermöglicht. Dann kann man Pods an beliebige VLANs, externe Netzwerke und auch VPNs anbinden. Und sobald Wireguard als Netzwerklösung noch etwas an Fahrt aufnimmt, lassen sich hier sicher auch Peering-Lösungen analog zu „VPCs“ basteln.
Bedenken
Nun möchte man sich fragen, warum das keiner macht. Offene Standards klingen ja erst mal gut. Firmen argumentieren gerne gegen diesen offenen Ansatz, sich zu viel Erfahrung neu aneignen zu müssen. Faktisch wird auf fertige Lösungen gesetzt, damit das Wissen über den Betrieb nicht eingekauft werden muss. Und so kaufen sich Firmen meist einfach Managed Services für ihre Dienste bei externen Betreibern und machen sich frei vom Hosting.
Das ist zwar bequem, birgt jedoch auch viele Gefahren. Zum einen wissen diese Betreiber genau, wie sie ihre Kunden binden können. Zum anderen wird den Firmen die technische Limitierung der Lösung oft erst zu spät bewusst. Auf der sicheren Seite ist man hier, wenn man prinzipiell auf Services mit Open-Source zur Grundlage setzt und die eigene Lösung nicht von den herstellerspezifischen Features abhängig macht. Und freuen kann man sich, wenn die Serviceprovider nicht nur Open-Source-Software nutzen, sondern sich auch an der Entwicklung dieser beteiligen.
Aus meiner Sicht wird sich in Europa diesbezüglich in den kommenden Jahren noch sehr viel wandeln. Zum einen haben wir uns zu einem Vorbild für Datenschutz entwickelt und sind Meister der Standards. Und gerade für Dienste aus dem Cloud-Umfeld brauchen wir Standards, die über die Hersteller hinweg gelten. Und zwar nicht Standards, die ein Unternehmen vorgibt. Die GAIA-X-Initiative geht hier einen richtigen Weg zur Interoperabilität und Standardisierung mehrerer Cloud-Anbieter. Und erste Provider stellen zumindest Clouds basierend auf Openstack „GAIA-X-kompatibel“ zur Verfügung.
Eine Sache weiß ich jedoch sicher: Meine AWS-Zertifizierung werde ich trotz Hinweis auf Verfall nicht erneuern. Hier eignet man sich für eine Prüfung größtenteils herstellerspezifische Details an, und das Zertifikat steht letztlich auch genau dafür. Leider scheinen hierzulande Firmen weiterhin sehr viel Wert auf spezifische Cloud-Kenntnisse zu legen. Ein Cloud-Engineer verliert gegen einen AWS-Cloud-Engineer, wenn die Infrastruktur dann auf AWS basiert. Aber die Cloud-Anbieter wissen, wie sie Nutzer und Firmen binden können. Wenn eine Firma zig AWS-Lizenzierungen Ihrer Mitarbeiter nachweisen kann, gibt es Ermäßigungen auf Cloud-Ressourcen und andere Dienste.
Realität
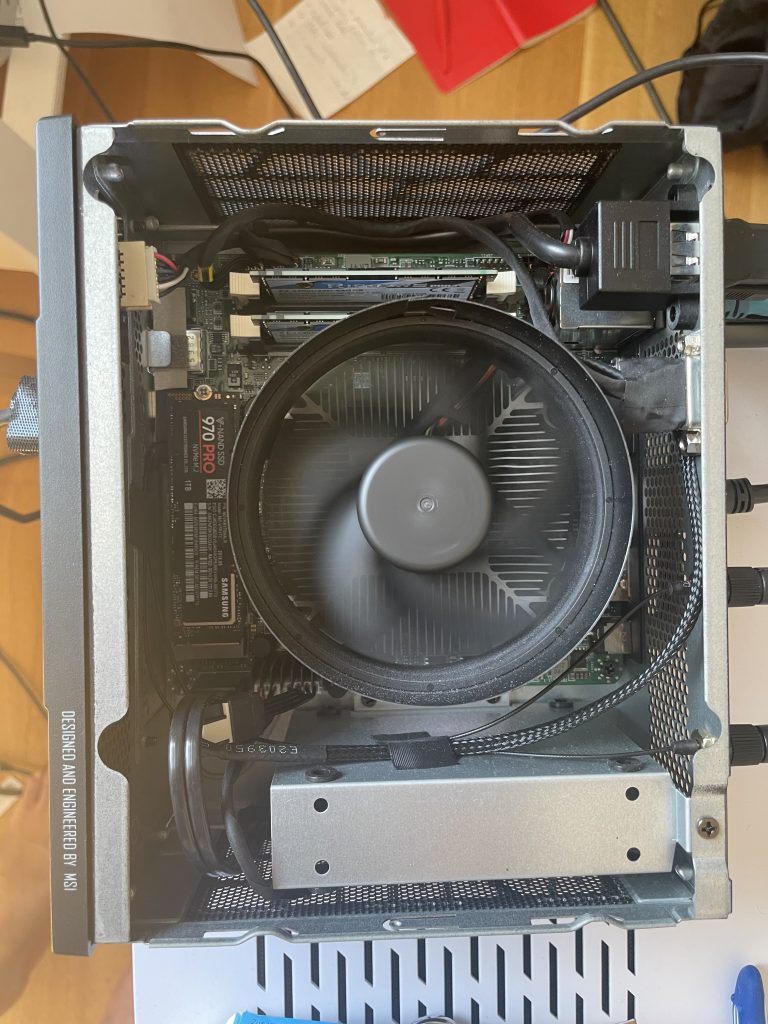
Aktuell läuft auf dem MSI-Rechner Proxmox. Das wird wie Windows zunächst per USB gebootet. Die zwei internen SSDs dienen als redundanter Speicherpool mit ZFS. Die Root-Volumes der virtuellen Maschinen werden hierauf abgelegt. Der Host wurde mit einem DNS-Eintrag in meinem lokalen DNS-Resolver des PiHole registriert und dort auch per DHCP mit einer statischen IP verknüpft.
In meinem Fall nicht notwendig, aber dennoch gut zu wissen: Beide NVME-SSDs sind in einem eigenen „PCI-Root-Komplex“, lassen sich also prinzipiell auch dediziert einzelnen VMs zuweisen.
Dann habe ich mir mit Cloud-Init ein Template für einen Ubuntu 20.04 Host erstellt, das mir eine einfache Provisionierung von VMs ermöglicht. Diese boote ich mit ebenfalls mit UEFI, und der neusten q35-Systemarchitektur. Ubuntu 22.04 fällt wegen Unterstützung in DeepOps aktuell flach. Der 5.4 Kernel in 20.04 schmerzt aber auch etwas bei meinem Threadripper-System, das hier beim Booten Probleme hat. Der HWE-Kernel kann zwar dieses Problem beheben, dann hat man aber plötzlich ein im Cloud-Umfeld ungetestetes System.
Das cloud-init-Template beinhaltet unter anderem auch DHCP-Konfiguration, SSH Keys, Benutzername, Passwort und Befehle zum Installieren von Paketen wie den Qemu Guest Tools (damit kann man VMs dann aus Proxmox sauber herunterfahren auch Snapshots der VM werden dadurch etwas sicherer während des Betriebs). Openstack lasse ich in diesem Setup zunächst außen vor. MaaS wird jedoch später ausgerollt, um auch nach dem ersten Start einer VM die Hoheit über die Konfiguration zu besitzen und eben auch echte Hardware einzubinden. Für Kubernetes benötigen wir für ein High-Availability-Cluster-3-Lehrer und mindestens einen Schüler. Zudem muss für das Deployment von DeepOps-Kubernetes-Clustern ein Deployment-Host für Ansible erstellt werden.
Ich setze also fümf virtuelle Maschinen auf. Die Lehrer erhalten folgende Ressourcen: 8 GB RAM, 2 vCPU, 50 GB Speicher. Die Schüler: 16 GB RAM, 4vCPU, 100 GB Speicher. Das Deployment: 4 GB RAM, 2vCPU, 10 GB Speicher.
Im Leerlauf zeigt der Rechner als Proxmox-Host im Übrigen erstaunlich wenig Verbrauch. Das war eine anfängliche Sorge beim Dauerbetrieb. 15 Watt ohne laufende virtuelle Maschinen ist sehr wenig (sogar leicht weniger als Windows im Leerlauf benötigte: 17 Watt). Ich hatte auch versucht, die vier Maschinen auf den ursprünglich vorhandenen 8 GB RAM unterzubringen, bin hier jedoch recht schnell an die Limits geraten. Dafür, dass dieser Rechner 24/7 Dienste bereitstellen wird, reichte mir das nicht.
Nach Kopieren des eigenen SSH Privatekeys auf die Deployment-VM, dem Klonen von DeepOps und der Konfiguration des Inventars geht es ans Deployment. Hier spielt sich der Templating-Aufwand von Cloud-Init dank der vorkonfigurierten VMs perfekt aus. Denn alle VMs sind nach dem ersten Boot mit dem Nutzernamen und dem SSH-Key ausgestattet, haben einen individuellen Hostnamen gesetzt, haben sich vom PiHole eine IP geholt und die Guest-Tools installiert. Nachdem Ansible per Kubespray ein Cluster auf den vier virtuellen Maschinen installiert hat, pegelte sich der Stromverbrauch für ein Idle Kubernetes-Cluster auf 18 Watt ein. Während des Deployments hat der Stromverbrauch naturgemäß stark geschwankt. Geschätzt um die 50 Watt im Schnitt.
Diese Werte lassen für mich auf einen realistischen Betrieb des Rechners mit Solarstrom schließen, da meine Solarmodule (2 x 160 Watt) selbst bei Abend- und Morgensonne und bei Nebel deutlich über diesem Verbrauch liegen und auch die effektive Kapazität (810 Wattstunden) über die Nacht ausreichen würde. Selbst bei 50 Watt.
Um den Energieverbrauch weiter zu minimieren, habe ich zudem versucht, auch meine Raspberry Pis (3 x 8 GB) von Microk8s auf DeepOps zu migrieren. Das hatte ich bisher für Lernzwecke im Kubernetes-Umfeld am Laufen, hier limitiert mich mittlerweile jedoch die Konfigurierbarkeit. Leider schlägt es mit den Raspberries aufgrund einer älteren Version von Kubespray in DeepOps noch fehl.
Ein Versuch, das Kubespray-Submodule zu aktualisieren, wirkte nur scheinbar, schlug dann aber an anderer Stelle auch wieder fehl. Das hätte zum einen den Vorteil gehabt, dass die Raspberries die Rolle des Lehrers einnehmen können, um weiterhin neue Deployments zu ermöglichen (die Kubernetes API wird von den Lehrern bedient), und zum anderen die Rolle des Schülers, um die eigenen Workloads weiter erreichbar zu halten. Als Zwischenschritt werde ich aber die Trennung zwischen Lehrer und Schüler nicht erzwingen und Workloads auf beiden ausführen.
Stromsparen würde hier unter der Prämisse erfolgen, den Rechner notfalls (bei wenig Akkustrom) einfach auszuschalten (oder analog alle Raspberry Pis herunterzufahren). Denn mein mobiler Akku lässt sich (leider bisher nur per Internet) bezüglich seines Ladezustands abfragen. Ob die drei Raspberry Pis aber im Kubernetes tatsächlich weniger Strom verbrauchen würden, sei dahingestellt. Für mich ist es aber primär wichtig, dass langlaufende Batch-Jobs früher oder später fertig werden und nicht wegen dem Herunterfahren einzelner Nodes verloren gehen. Und im Idealfall schaltet sich die Hardware, die nicht benötigt wird, automatisch ab.
Monitor
Mit dem Monitor bin ich ebenfalls sehr zufrieden! Er hat sowohl sehr gute Farben, als auch eine angenehm schnelle Reaktionszeit beim Spielen. Die Helligkeit beeindruckt selbst bei einfallendem Tageslicht, dort ist zudem die matte Folierung ein echter Segen. Durch Hardware konnte ich die Reaktionsfähigkeit leider nicht messen, aber es ist definitiv spürbar im Vergleich zu meinem alten 5K Monitor. Ob ich durch das Arbeiten an dem Monitor weniger schnell müde werde, kann ich jedoch nicht abschließend beurteilen, da hier viele Einflüsse, unter anderem Kaffee, mit reinspielen.
Was mich in der Kombination des Rechners mit dem Bildschirm etwas verwundert hat ist der VESA-Mount des Rechners. Zwar könnte ich den Rechner an die Displayhalterung schrauben, dann jedoch natürlich nicht mehr das Display. Also hat sich hier die Frage aufgetan, ob man dafür eine Halterung mit zwei Armen bräuchte, oder ob es Displays gibt die eine Montage des Rechners erlauben würden.
Was mir am Display negativ aufgefallen ist, ist die Navigation. Die Menüs könnten durch die Knöpfe an der Seite nicht unintuitiver navigiert werden. Weder gibt das UI einen Indikator, welcher Knopf nun welche Funktion in welchem Menü einnimmt, noch dreht sich das UI, wenn man den Display gedreht hat. Und dadurch dass sie hinten am Monitor liegen, darf man sich erstmal ertasten, welcher nun der oberste Knopf ist.
Und den Sound, den kann man wirklich nur im Notfall ertragen. Aber dafür ist ja ein Display auch nicht da.
Autor: Till Heinzerling
Dieser Beitrag ist bereits älter als 90 Tage. Hier finden Sie die Übersicht neuer Sponsored Articles
.